KI-Automatisierung
LLM vs. NCM: Was Next-Concept Modeling kann und wie viel Speicher es braucht
Next-Concept Modeling (NCM) aus Stanford schreibt Texte nicht Wort für Wort, sondern vom groben Entwurf zum fertigen Text und ist dabei deutlich schneller als vergleichbare Verfahren. Wir vergleichen Speicherbedarf und Verfügbarkeit mit klassischen Sprachmodellen und zeigen, was davon heute schon nutzbar ist.
· 9 Minuten Lesezeit · von Rainer Winkler
Seit Mitte Oktober 2026 kursiert ein neues Kürzel: NCM, Next-Concept Modeling. Eine Forschungsgruppe der Stanford University hat ein Verfahren vorgestellt, das Texte nicht mehr Wort für Wort schreibt wie ChatGPT, Claude oder Gemini, sondern vom groben Entwurf zum fertigen Text, mit vielen Stellen gleichzeitig. In sozialen Netzwerken war schnell vom „Ende der LLMs“ die Rede.
Wir ordnen ein, was dahintersteckt, wie viel Speicher solche Modelle brauchen, welche Modelle es heute frei oder in der Cloud gibt und wo die Grenzen liegen.
Kurz gesagt
- NCM ist ein Forschungsverfahren der Gruppe Hazy Research an der Stanford University, veröffentlicht am 9. Oktober 2026. Es erzeugt Text in Ebenen vom Groben zum Feinen und berechnet alle Stellen einer Ebene gleichzeitig.
- In den Tests der Autoren war NCM 10- bis 31-mal schneller als die stärksten Diffusions-Sprachmodelle und brauchte vier- bis fünfmal weniger Trainingsdaten. Verglichen wurde mit kleinen Forschungsmodellen, nicht mit ChatGPT oder Claude.
- Beim Speicher gibt es keinen Wundereffekt: Der Bedarf hängt an der Zahl der Parameter, nicht am Verfahren. Die bisherigen NCM-Modelle sind mit höchstens 725 Millionen Parametern klein und passen deshalb in rund 1,5 GB.
- Fertige NCM-Modelle für den Arbeitsalltag gibt es weder zum Herunterladen noch in der Cloud. Wer parallele Textgenerierung heute nutzen will, greift zu Diffusions-Sprachmodellen wie DiffusionGemma (frei) oder Mercury (Cloud).
Wie ein LLM schreibt und wie NCM schreibt
Ein klassisches Large Language Model (LLM) schreibt Text Stück für Stück. Es sagt das nächste Wortstück voraus, hängt es an und beginnt von vorn. Für eine Antwort mit 500 Wortstücken läuft das Modell 500-mal durch. Weil es dabei jedes Mal einen großen Teil seiner Gewichte aus dem Speicher lesen muss, bestimmt vor allem die Speichergeschwindigkeit das Tempo. Mehr dazu in unserem Ratgeber Hardware für lokale KI.
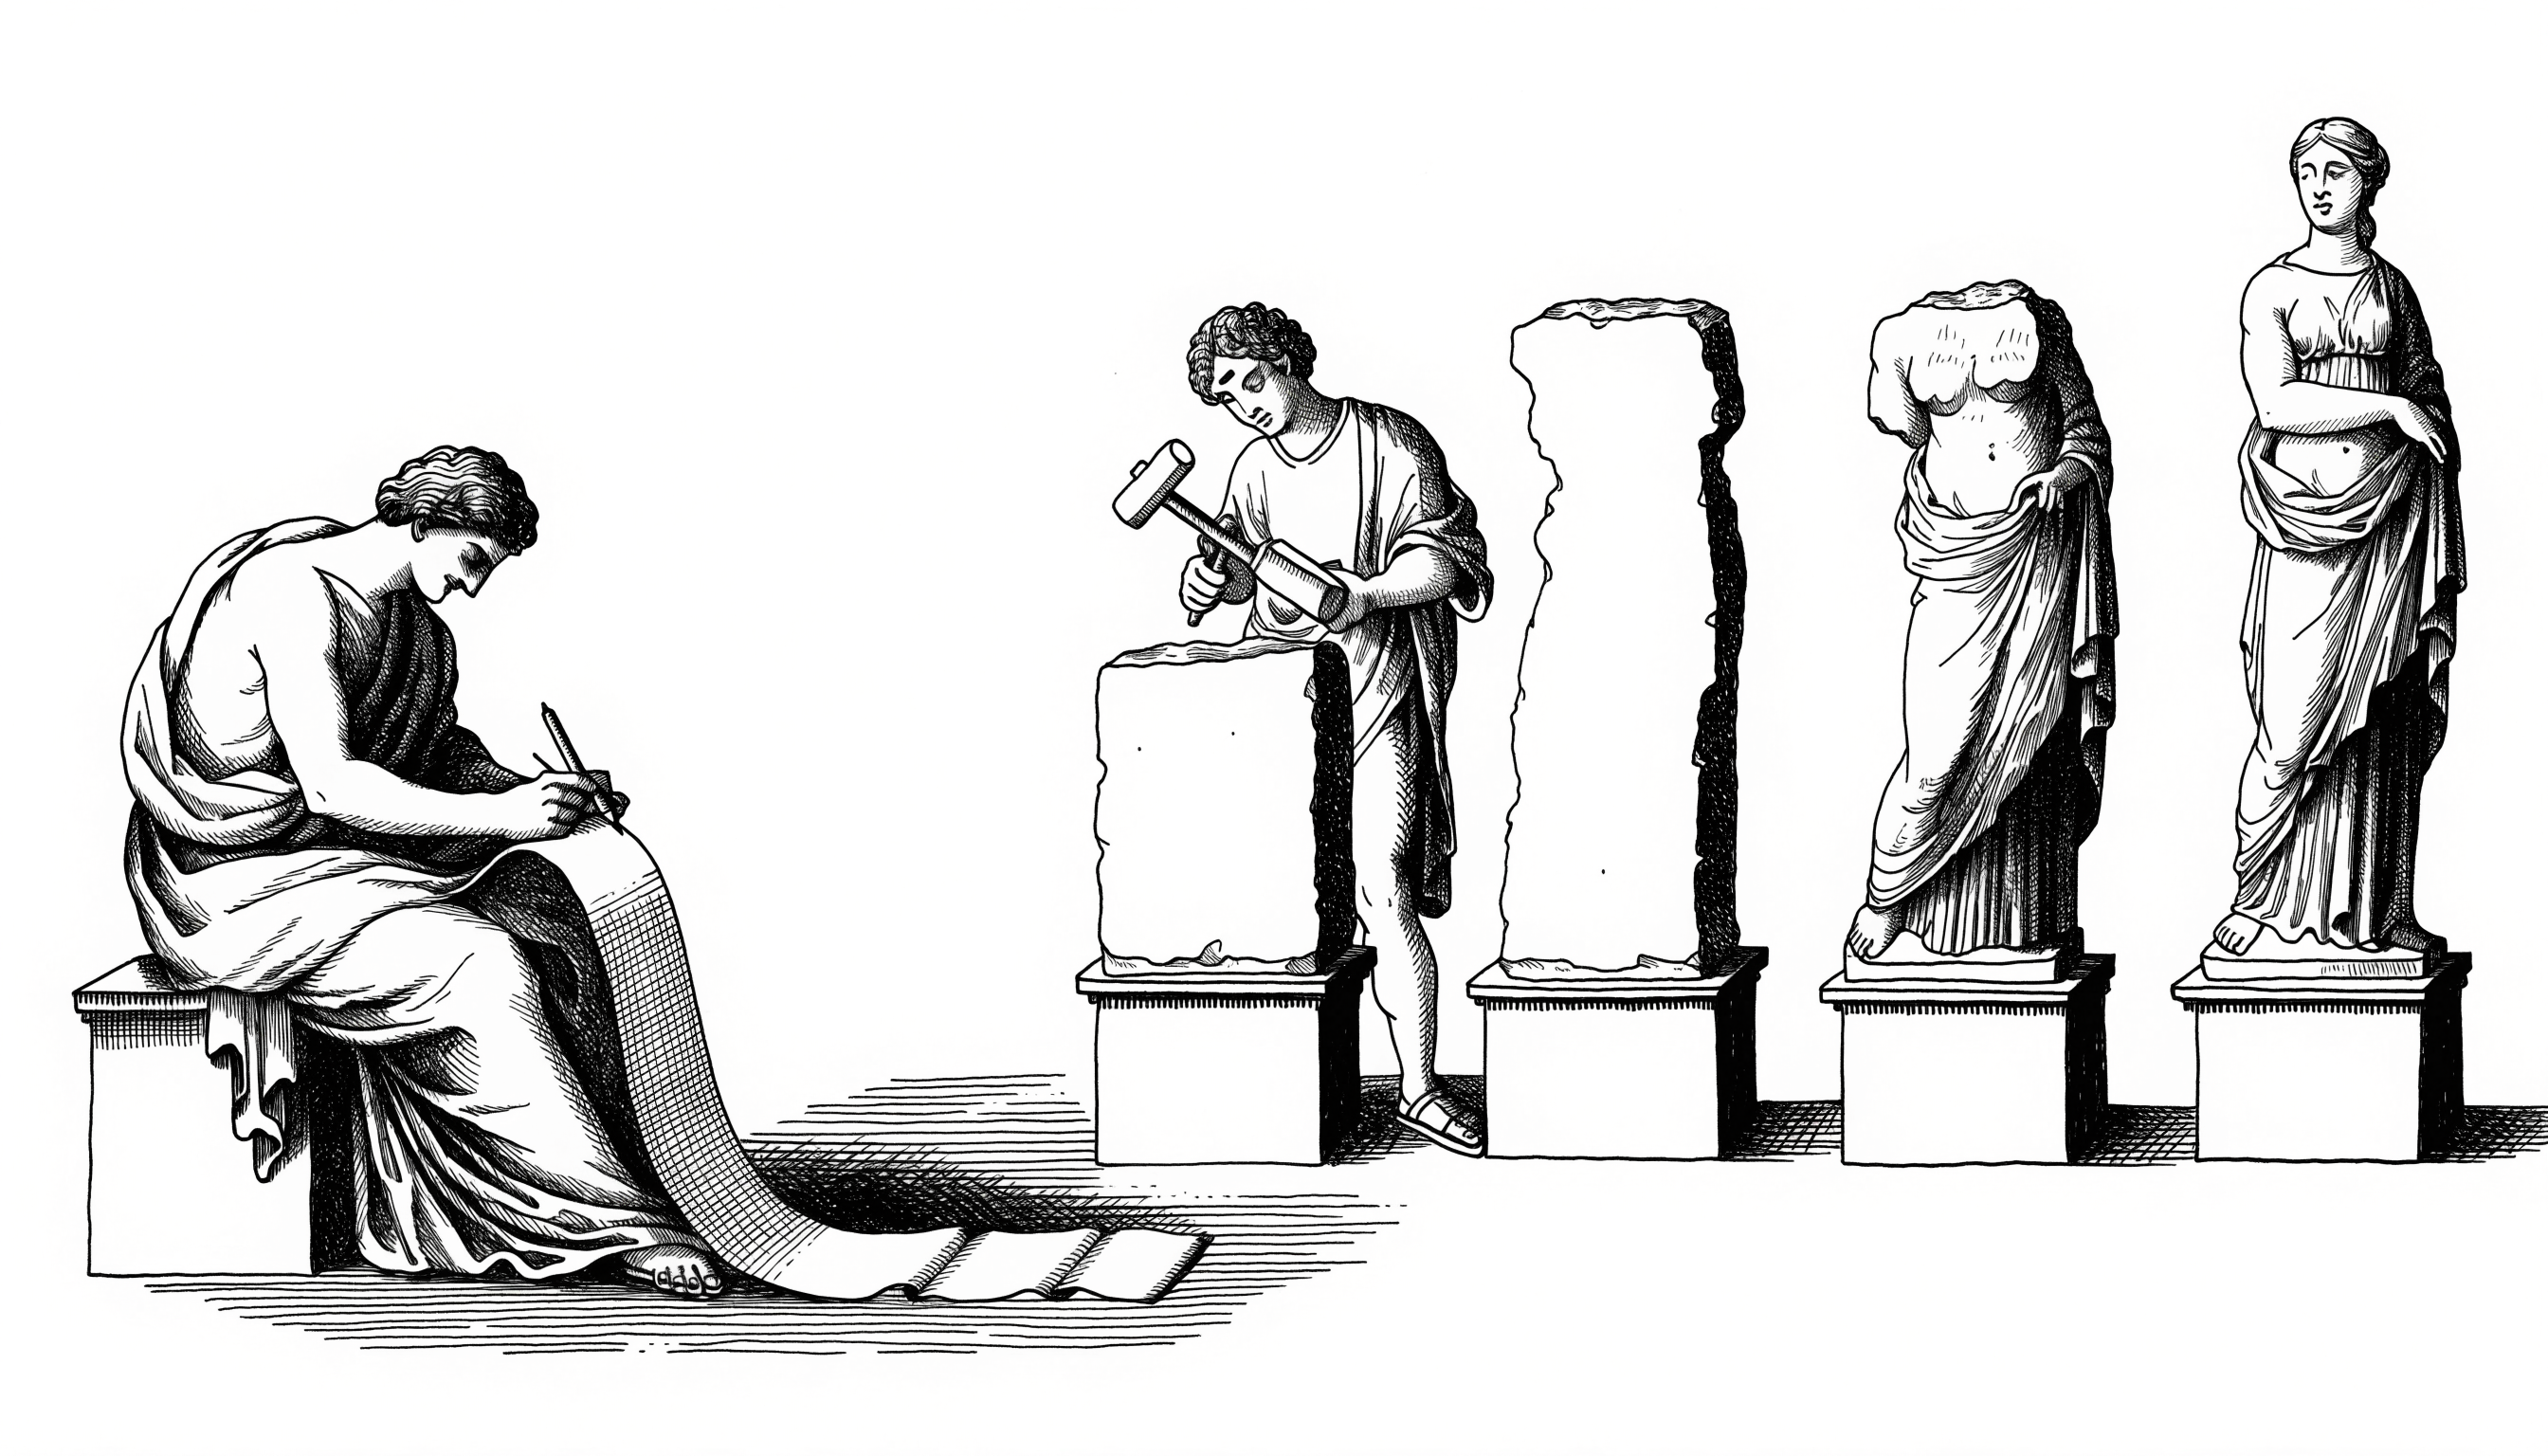
NCM arbeitet wie ein Bildhauer, der erst die grobe Form aus dem Block schlägt und dann immer feiner wird:
- Zerlegen: Ein eigener Baustein, der Tokenizer, übersetzt Text in eine Hierarchie von Codes. Die oberste Ebene beschreibt grob, worum es geht, jede weitere Ebene fügt Einzelheiten hinzu.
- Erzeugen: Ein Transformer, die übliche Bauweise von Sprachmodellen, sagt diese Ebenen nacheinander voraus. Alle Codes innerhalb einer Ebene berechnet er gleichzeitig.
- Zurückübersetzen: Ein Decoder macht aus der fertigen Hierarchie wieder lesbaren Text.
Für eine Übersetzung brauchte NCM in den Tests elf Durchgänge, einen je Ebene, unabhängig von der Länge des Satzes. Die erste Ebene ist dabei kaum lesbar, erst die letzte liefert den fertigen Text.
| Verfahren | So entsteht der Text | Durchgänge | Reifegrad |
|---|---|---|---|
| LLM (autoregressiv) | Wortstück für Wortstück, von links nach rechts | einer je Wortstück | im Alltag erprobt |
| Diffusions-Sprachmodell | alle Stellen gleichzeitig, in vielen Schritten verfeinert | viele Verfeinerungsschritte | erste Produkte |
| NCM | Ebene für Ebene vom Groben zum Feinen, je Ebene alles gleichzeitig | einer je Ebene, etwa elf | Forschung |
Was die Messungen zeigen
Die Autoren um Hermann Kumbong, Ishan Khare und Christopher Ré haben NCM vor allem mit Diffusions-Sprachmodellen gleicher Größe verglichen:
- Bei frei erzeugtem Text war NCM 21-mal (Datensatz LM1B) und 10-mal (OpenWebText) schneller, bei gleicher oder besserer Qualität.
- Beim Zusammenfassen von Nachrichtentexten (XSum) erreichte es dieselbe Qualität und war bis zu 31-mal schneller.
- Für dieselbe Qualität brauchte es rund vier- bis fünfmal weniger Trainingsdaten.
- Bei schweren Sudokus löste NCM 86 Prozent der Rätsel, ein gleich großes LLM 1 Prozent.
Ein unabhängiger Test, den der Softwareanbieter MindStudio am 29. Oktober 2026 veröffentlichte, zeichnet ein gemischteres Bild. Auf einem Nvidia DGX Spark war NCM bei einer einzelnen Anfrage etwa viermal (Übersetzung) und zweimal (Zusammenfassung) so schnell wie ein gleich großes LLM. Bei 64 gleichzeitigen Anfragen war dagegen das LLM schneller. NCM verarbeitet rund viermal so viele Stellen, wie es am Ende Wörter ausgibt, und liest in der veröffentlichten Fassung die ganze Eingabe in jedem Durchgang neu. Den Sudoku-Vorsprung erreichte im Test auch ein Diffusionsmodell, wenn es geschickter decodiert wurde. Er geht also weniger auf die Bauweise zurück als auf die Reihenfolge, in der die Lücken gefüllt werden.
Speicherbedarf im Vergleich
Wie viel Speicher ein Modell braucht, hängt in erster Linie an der Zahl seiner Parameter und daran, wie genau sie gespeichert werden. In voller Genauigkeit (16 Bit) belegt jeder Parameter 2 Byte, in 4 Bit etwa ein Viertel davon. Dieser Kniff heißt Quantisierung. Dazu kommt Platz für die Eingabe und die Zwischenergebnisse.
| Modell | Verfahren | Parameter | Speicher für die Gewichte |
|---|---|---|---|
| NCM, größtes Forschungsmodell | NCM | 725 Mio. | rund 1,5 GB in 16 Bit |
| LLaDA2.2-mini | Diffusion | 16 Mrd., davon 1,4 Mrd. aktiv | rund 32 GB in 16 Bit, rund 9 GB in 4 Bit |
| DiffusionGemma 26B-A4B | Diffusion | 25,2 Mrd., davon 3,8 Mrd. aktiv | rund 50 GB in 16 Bit, rund 14 GB in 4 Bit |
| Qwen3.8-27B | LLM | 27 Mrd. | 56 GB in 16 Bit, 18 GB in 4 Bit |
| GLM-5.3 | LLM | 753 Mrd. | rund 756 GB in 8 Bit |
| Kimi K3 | LLM | 2,8 Billionen | rund 1,4 bis 1,6 TB in 4 Bit |
Werte für NCM, LLaDA und DiffusionGemma sind unsere Rechnung aus der Parameterzahl, ohne Platz für Eingabe und Zwischenergebnisse. Qwen laut Ollama-Bibliothek, GLM und Kimi laut Modelldateien auf Hugging Face. Stand November 2026.
Die Tabelle zeigt zweierlei. Erstens ist NCM nur deshalb so klein, weil die Forscher bisher nur kleine Modelle trainiert haben. Ein NCM mit 27 Milliarden Parametern bräuchte für seine Gewichte ähnlich viel Speicher wie ein gleich großes LLM. Zweitens liegt der Vorteil von NCM nicht beim Speicherplatz, sondern bei der Zahl der Durchgänge: Elf Durchgänge statt Hunderte heißen, dass die Gewichte seltener aus dem Speicher gelesen werden müssen. Das macht es bei einzelnen Anfragen schneller.
Hinzu kommt der Arbeitsspeicher während des Rechnens. Ein LLM legt für jedes verarbeitete Wortstück Zwischenergebnisse ab, den sogenannten KV-Cache, der bei langen Dokumenten mehrere Gigabyte belegen kann. Die veröffentlichte NCM-Fassung rechnet die Eingabe stattdessen in jedem Durchgang neu, ein Zwischenspeicher für die Eingabe funktionierte im unabhängigen Test nicht richtig. Belastbare Messungen zum Arbeitsspeicher von NCM gibt es bisher nicht, die Autoren machen dazu keine Angaben.
Freie Modelle zum Herunterladen
NCM
Hazy Research hat Code und Modelldateien unter der freien MIT-Lizenz veröffentlicht, die Modelldateien liegen auf Hugging Face (insgesamt rund 8 GB). Es gibt Modelle für einzelne Aufgaben: Zusammenfassung englischer Nachrichtentexte, Übersetzung Deutsch–Englisch, Sudoku sowie allgemeine Textmodelle in drei Größen. Mitgeliefert werden nur Skripte, um die Ergebnisse des Papiers nachzurechnen, keine Chat-Oberfläche und kein Trainingscode. Für Neugierige mit einer Nvidia-Grafikkarte ist das ein spannendes Experiment, für den Einsatz im Betrieb taugt es nicht.
Verwandte Modelle, die heute schon laufen
Die nächsten Verwandten von NCM sind Diffusions-Sprachmodelle. Auch sie schreiben viele Stellen gleichzeitig, nur in mehr Schritten. Davon gibt es inzwischen alltagstaugliche offene Modelle:
| Modell | Anbieter | Größe | Lizenz | Besonderheit |
|---|---|---|---|---|
| DiffusionGemma 26B-A4B | Google DeepMind | 25,2 Mrd., 3,8 Mrd. aktiv | Apache 2.0 | versteht Text, Bilder und Video, bis 256.000 Tokens Kontext, über 1.100 Tokens pro Sekunde auf einer H100 |
| LLaDA2.2-mini | inclusionAI (Ant Group) | 16 Mrd., 1,4 Mrd. aktiv | Apache 2.0 | bis 128.000 Tokens Kontext, auf Agentenaufgaben ausgelegt |
| Large Concept Model | Meta | 1,6 Mrd. im Trainingsrezept | MIT (Code) | arbeitet mit ganzen Sätzen als „Konzepten“, nur Trainingscode, keine fertigen Gewichte |
DiffusionGemma ist der realistischste Kandidat für einen Test im eigenen Haus. In 4 Bit passt es auf eine Grafikkarte mit 16 bis 24 GB. Google räumt aber ein, dass es in den meisten Tests hinter dem gleich großen, klassischen Gemma 4 liegt, bei der Mathematik-Olympiade AIME 2026 etwa mit 69,1 gegenüber 88,3 Prozent. Man tauscht Qualität gegen Tempo.
Cloud-Angebote
Ein NCM als Cloud-Dienst gibt es Stand November 2026 nicht. Diffusions-Sprachmodelle lassen sich dagegen bereits über Programmierschnittstellen nutzen:
| Modell | Anbieter | Eingabe | Ausgabe |
|---|---|---|---|
| Mercury 3 | Inception | 0,10 $ | 0,35 $ |
| Mercury 2 | Inception | 0,25 $ | 0,75 $ |
| zum Vergleich: GLM-5.3-Flash (LLM) | Z.ai | 0,15 $ | 0,50 $ |
| zum Vergleich: Claude Sonnet 5.5 (LLM) | Anthropic | 2 $ | 10 $ |
Preise je eine Million Tokens. Mercury laut OpenRouter, abgerufen am 3. November 2026, übrige laut Preislisten der Anbieter vom 27. Oktober 2026.
Inception aus den USA ist der bekannteste Anbieter von Diffusions-Sprachmodellen. DiffusionGemma bieten zudem Hoster wie Baseten an. Googles eigenes Gemini Diffusion war bisher nur als Vorschau zugänglich, einen allgemein verfügbaren Dienst haben wir nicht gefunden. Wie bei jedem Cloud-Dienst gilt: Vor dem Einsatz mit personenbezogenen Daten Vertrag zur Auftragsverarbeitung und Ort der Verarbeitung prüfen.
Vorteile von NCM
- Tempo bei einzelnen Anfragen: Wenige Durchgänge statt Hunderte. Das kommt vor allem dem lokalen Betrieb zugute, bei dem eine Person auf eine Antwort wartet.
- Weniger Trainingsdaten: Vier- bis fünfmal weniger als Diffusionsmodelle für dieselbe Qualität. Das könnte eigene Spezialmodelle günstiger machen.
- Planung vor Formulierung: Die grobe Ebene legt erst fest, worum es geht, bevor Einzelheiten entstehen. Bei Aufgaben mit festen Regeln wie Sudoku war das in den Tests ein Vorteil.
- Freie Lizenz: Code und Modelle stehen unter MIT-Lizenz und dürfen frei verwendet werden.
Grenzen von NCM
- Nur kleine Forschungsmodelle: Das größte Modell hat 725 Millionen Parameter, rund ein Vierzigstel eines Qwen3.8-27B. Ob das Verfahren bei Milliarden Parametern genauso gut funktioniert, ist offen. Die Autoren nennen ihre Ergebnisse zur Skalierung selbst „vorläufig“.
- Kein Vergleich mit Spitzenmodellen: Die großen Geschwindigkeitsgewinne beziehen sich auf Diffusionsmodelle, nicht auf LLMs wie GPT, Claude oder Qwen.
- Schwach bei vielen gleichzeitigen Anfragen: Für Server, Kundenportale oder Agenten mit vielen parallelen Aufgaben war im unabhängigen Test ein klassisches LLM schneller.
- Kein Mitlesen: NCM gibt den Text erst am Ende aus. Das gewohnte Erscheinen Wort für Wort entfällt.
- Feste Ausgabelänge: Die Länge der Antwort ist vorab festgelegt, egal wie kurz die Antwort sein könnte.
- Namen und Zahlen: Im unabhängigen Test gab NCM Namen und Zahlen gelegentlich falsch wieder. Für Rechnungen, Verträge oder Daten ist das ein Ausschlussgrund.
- Kein Ökosystem: Keine Chat-Oberfläche, keine Einbindung in gängige Werkzeuge wie Ollama, kein Trainingscode, keine Cloud-Angebote.
Was heißt das für Ihr Unternehmen?
- Kein Handlungsbedarf bei NCM. Das Verfahren ist ein interessanter Forschungsansatz, aber kein Ersatz für die Sprachmodelle, die Sie heute einsetzen. Bestehende Projekte müssen Sie deswegen nicht anpassen.
- Diffusionsmodelle im Blick behalten. Wo Tempo wichtiger ist als die letzte Qualitätsstufe, etwa bei Autovervollständigung, kurzen Entwürfen oder Klassifizierung, lohnt sich ein Test mit DiffusionGemma oder Mercury.
- Austauschbar bauen. Neue Verfahren kommen inzwischen im Halbjahrestakt. Wer seine Anwendungen so baut, dass sich das Modell wechseln lässt, kann von solchen Sprüngen profitieren, ohne neu anzufangen.
- Hardware nach Modellgröße planen. Für den Speicherbedarf zählt die Zahl der Parameter, nicht das Etikett. Die Faustregeln aus unserem Ratgeber Hardware für lokale KI gelten auch für neue Verfahren.
Wenn Sie prüfen möchten, ob ein schnelles lokales Modell für einen Ihrer Abläufe reicht, unterstützen wir Sie mit einer KI-Beratung.
Unsere Einschätzung
NCM ist eine elegante Idee: erst die grobe Form, dann die Einzelheiten, und das mit wenigen Durchgängen. Die Zahlen gegenüber Diffusionsmodellen sind beeindruckend. Vom „Ende der LLMs“ kann aber keine Rede sein. Getestet wurden Modelle, die kleiner sind als jedes Sprachmodell, das heute im Büro läuft, und bei vielen gleichzeitigen Anfragen liegt das klassische Verfahren vorn. Spannend wird es, wenn jemand ein NCM in der Größenordnung von 10 bis 30 Milliarden Parametern trainiert. Bis dahin sind Diffusions-Sprachmodelle der praktische Weg, parallele Textgenerierung auszuprobieren.
Quellen
- Hermann Kumbong, Ishan S. Khare u. a.: Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation, arXiv 2610.14162, 09.10.2026 – https://arxiv.org/abs/2610.14162
- Next-Concept Modeling, Hazy Research, Stanford University, 12.10.2026 – https://hazyresearch.stanford.edu/blog/2026-10-12-ncm
- HazyResearch/ncm, GitHub – https://github.com/HazyResearch/ncm
- NCM-Modelldateien, Hugging Face – https://huggingface.co/hazyresearch/ncm-checkpoints
- NCM vs LLMs: Independent Speed Benchmark Results Explained, MindStudio, 29.10.2026 – https://www.mindstudio.ai/blog/ncm-vs-llm-speed-benchmark-test
- NCM vs. LLM: Was Next-Concept Modeling wirklich verändert, cyberEiche – https://blog.cybereiche.de/ncm-vs-llm-was-next-concept-modeling-wirklich-veraendert-und-was-nicht/
- DiffusionGemma 26B-A4B, Modellkarte, Google, Hugging Face – https://huggingface.co/google/diffusiongemma-26B-A4B-it
- LLaDA2.2-mini, Modellkarte, inclusionAI, Hugging Face – https://huggingface.co/inclusionAI/LLaDA2.2-mini
- Large Concept Model, Meta, GitHub – https://github.com/facebookresearch/large_concept_model
- Mercury 3 und Mercury 2, Inception, OpenRouter, abgerufen am 03.11.2026 – https://openrouter.ai/inception
- DiffusionGemma bei Baseten – https://docs.baseten.co/examples/models/llm/diffusiongemma
- Ollama: Varianten von Qwen 3.8 – https://ollama.com/library/qwen3.8/tags
- Modellkarten GLM-5.3 und Kimi K3, Hugging Face – https://huggingface.co/zai-org/GLM-5.3, https://huggingface.co/moonshotai/Kimi-K3
- Preislisten, abgerufen am 27.10.2026: Z.ai, Anthropic
Dieser Beitrag wurde mit KI-Unterstützung aus den genannten Quellen zusammengestellt und von der Redaktion geprüft.
Änderungsprotokoll
Aktuelle Version 1.0 · Stand:
- Version 1.0 Erstveröffentlichung am